


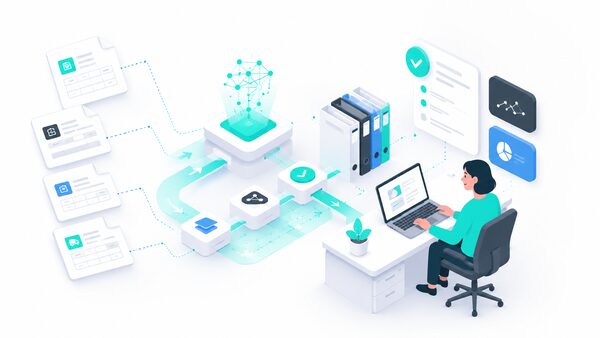
Demandez à ChatGPT quelle est votre politique de congés, votre grille tarifaire ou les conditions d'un contrat signé au printemps : soit il avoue qu'il n'en sait rien, soit il vous donne avec aplomb une réponse fausse. Il n'a jamais vu vos documents. Le RAG est la technique qui règle ce problème, et c'est elle qui se cache derrière la plupart des assistants « interrogez notre documentation » que les entreprises ont lancés ces deux dernières années.
Alors, qu'est-ce que le RAG ? Une façon de connecter un modèle d'IA à vos propres informations pour qu'il réponde à partir de vos manuels, procédures, contrats et bases documentaires, et non de mémoire. Ce guide explique simplement comment cela fonctionne, d'où viennent les informations, comment sont gérés les droits d'accès et la sécurité, combien coûte la mise en place et dans quels cas c'est rentable. Si vous savez déjà que vous en avez besoin, passez directement à la partie prix et calculez une estimation pour votre cas.
Sommaire
- Qu'est-ce que le RAG ?
- RAG ou ChatGPT : quelle différence ?
- D'où un système RAG tire-t-il ses informations ?
- Droits d'accès : qui peut voir quoi
- Garder l'information à jour
- Citer les sources : plus important qu'il n'y paraît
- Sécurité et confidentialité
- Combien coûte la mise en place d'un RAG ?
- Les cas d'usage où le RAG est rentable
- Comment démarrer un projet RAG
Qu’est-ce que le RAG ?
RAG signifie retrieval-augmented generation, que l’on traduit par génération augmentée par la recherche. Le terme vient d’un article de recherche publié en 2020 par Lewis et ses collègues de Facebook AI Research. Il décrit les deux étapes que le système exécute à chaque question :
- La recherche. Le système parcourt vos documents et sélectionne les quelques passages qui ont le plus de chances de contenir la réponse.
- La génération. Il envoie ces passages, avec la question, à un modèle de langage (GPT, Claude, Gemini, Mistral, Llama…) et lui donne une consigne : réponds uniquement à partir de ce texte, et dis-le si la réponse n’y est pas.
C’est toujours le modèle qui rédige, donc la réponse se lit naturellement. Mais les faits viennent de vos documents, pas de ce que le modèle a retenu pendant son entraînement. Toute l’idée est là.
Pour que la recherche fonctionne, les documents sont préparés à l’avance : le texte est extrait, découpé en courts passages et stocké dans un index que l’on interroge par le sens plutôt que par les mots exacts. C’est ce qui permet à la question « combien de jours de congé ai-je après un an ? » de trouver le paragraphe intitulé « Droits à congés payés ».
RAG ou ChatGPT : quelle différence ?
ChatGPT, Copilot ou Gemini, utilisés seuls, sont des assistants généralistes. Ils rédigent, résument et raisonnent très bien, et en savent beaucoup sur le monde jusqu’à leur date d’entraînement. Sur votre entreprise, ils ne savent rien, sauf si quelqu’un colle l’information dans la conversation.
Un système RAG fait ce copier-coller automatiquement, à chaque question, avec les bons documents, et uniquement ceux que la personne qui pose la question a le droit de voir.
| Chatbot généraliste (ChatGPT seul) | Système RAG | |
|---|---|---|
| Origine des réponses | Ce que le modèle a appris à l’entraînement | Vos documents, interrogés au moment de chaque question |
| Information propre à l’entreprise | Seulement si on la colle | Intégrée, depuis toutes les sources connectées |
| Quand un document change | Ne le sait pas | Utilise la nouvelle version dès la réindexation |
| Citation de la source | Non | Oui, document et page |
| Quand il ne sait pas | Peut inventer une réponse plausible | Peut répondre « je ne trouve pas cette information » |
| Droits d’accès | Sans objet | Chacun n’obtient de réponses que sur ce qu’il peut consulter |
On nous demande souvent s’il ne vaudrait pas mieux « entraîner ChatGPT sur nos données ». C’est ce qu’on appelle le fine-tuning, et pour le savoir de l’entreprise c’est rarement le bon outil : c’est cher, à refaire à chaque changement et incapable d’indiquer d’où vient une réponse. Le fine-tuning sert à apprendre un style ou un format à un modèle. Pour des faits, c’est le RAG qu’il vous faut.
D’où un système RAG tire-t-il ses informations ?
De là où vos documents se trouvent déjà. Un système bien conçu lit les sources existantes au lieu d’obliger tout le monde à migrer ses fichiers vers un nouvel outil. Les plus courantes :
- Les dossiers SharePoint, OneDrive et Google Drive
- Les wikis et bases de connaissances comme Confluence ou Notion
- La GED (gestion électronique des documents), où se trouvent souvent contrats et dossiers
- Les articles d’aide et l’historique des tickets de support
- Les données structurées d’un CRM, d’un ERP ou d’une base interne, quand la réponse dépend de chiffres à jour
Les documents qui fonctionnent le mieux
Le texte numérique propre (fichiers Word, Google Docs, PDF générés par ordinateur) est le cas facile. Tout se complique, et coûte plus cher, avec les pages scannées ou photographiées, les tableaux complexes et fichiers Excel, les plans techniques et tout ce qui est encore sur papier. Il faut d’abord transformer tout cela en texte lisible, et c’est la partie du budget la plus souvent sous-estimée.
L’autre piège, c’est la qualité. Si votre lecteur partagé contient trois versions de la même procédure, le système trouvera les trois. Tout projet sérieux commence par décider quels documents font foi et lesquels restent à l’écart.
Droits d’accès : qui peut voir quoi
C’est la question qui transforme un projet de deux mois en projet de cinq mois, et presque personne ne la pose au premier rendez-vous.
Si tout le monde peut ouvrir tous les documents, la question est réglée. Dans la plupart des entreprises, ce n’est pas le cas : dossiers RH, procès-verbaux du comité de direction, grilles de salaires et contrats clients sont restreints. Un système RAG doit respecter ces restrictions dans chaque réponse. Sinon, n’importe qui pourrait demander à l’assistant ce qu’il ne peut pas ouvrir lui-même, et l’IA le lui résumerait volontiers.
On distingue en général trois niveaux :
- Ouvert à tous. Une base commune, sans restriction. L’option la moins chère, parfaite pour les contenus d’aide publics.
- Par service. Le commercial voit les documents commerciaux, la technique les documents techniques. Effort modéré.
- Par personne ou par client. Le système vérifie pour chaque utilisateur les droits d’origine de chaque document, le plus souvent en les lisant dans SharePoint ou Google Drive. L’option la plus solide et la plus lourde.
Garder l’information à jour
L’un des grands avantages du RAG sur un modèle réentraîné : les mises à jour coûtent peu. Quand un document change, seul ce document doit être relu et réindexé. La fréquence est un choix de conception :
- Une synchronisation chaque nuit ou chaque semaine suffit quand les documents bougent peu.
- Une mise à jour quasi en temps réel se justifie pour les contenus de support, les grilles tarifaires et tout ce qui change plusieurs fois par semaine.
- Les documents supprimés ou périmés doivent aussi disparaître de l’index. C’est facile à oublier, et cela provoque certaines des erreurs les plus gênantes.
Citer les sources : plus important qu’il n’y paraît
Un système RAG sait exactement quels passages il a utilisés pour chaque réponse, il peut donc les afficher. Certains projets se contentent de nommer le document, d’autres renvoient à la page exacte et l’ouvrent en un clic.
Cela ressemble à un bonus. En pratique, c’est ce qui décide si les gens font confiance à l’outil. Un collaborateur qui peut vérifier la source en deux secondes s’appuie sur la réponse ; celui qui ne peut pas retourne demander à sa collègue. Les citations rendent aussi les erreurs visibles très vite, et c’est ainsi que le système progresse.
Sécurité et confidentialité
La première question de la DSI et du service juridique est presque toujours : nos documents vont-ils servir à entraîner l’IA de quelqu’un d’autre ? Avec les contrats professionnels des grands fournisseurs, non. OpenAI indique par exemple qu’il n’entraîne pas ses modèles sur les données professionnelles envoyées via son API ou ses offres entreprise, et Microsoft explique comment construire un RAG avec Azure AI Search dans votre propre environnement Azure.
Au-delà, les décisions qui comptent sont les suivantes :
- Où les données sont traitées. Pour une entreprise européenne, des centres de données dans l’UE sont en général indispensables au titre du RGPD.
- Quel modèle. Pour les informations les plus sensibles (santé, finance, juridique), le système peut tourner sur des modèles open source, y compris ceux de Mistral AI, déployés dans votre propre cloud, sans que rien ne sorte de votre infrastructure.
- La traçabilité. Qui a demandé quoi, et quels documents ont été utilisés, doit être enregistré et consultable.
- La transparence. Si des clients ou le public utilisent l’assistant, le règlement européen sur l’IA impose de leur indiquer qu’ils s’adressent à une IA.
Combien coûte la mise en place d’un RAG ?
Moins que ce que la plupart imaginent pour un pilote, plus pour un système à l’échelle de l’entreprise. Le modèle d’IA est rarement le poste le plus cher. Le prix dépend du nombre et de l’état des documents, du nombre d’endroits où ils sont stockés, du modèle de droits d’accès et de la nécessité de citer la page exacte.
| Type de projet | Périmètre type | Mise en place | Coûts récurrents |
|---|---|---|---|
| Pilote | Une équipe, une source, des documents propres, une interface web simple | 5 000 – 15 000 € HT | 150 – 600 € HT/mois |
| Système de service | Plusieurs sources, droits par service, citations, Teams ou Slack | 15 000 – 35 000 € HT | 600 – 2 000 € HT/mois |
| Toute l’entreprise | Nombreuses sources, documents scannés, droits par personne, données sensibles | 35 000 – 60 000 € HT et plus | à partir de 2 000 € HT/mois |
Ce sont des fourchettes indicatives pour le marché européen. Les coûts récurrents couvrent le modèle d’IA, l’index de recherche et l’hébergement, et augmentent avec le nombre de questions : un outil pour 20 collaborateurs coûte bien moins cher à faire tourner qu’un assistant ouvert à tous vos clients.
Le lieu où travaille l’équipe pèse aussi. Une bonne partie des entreprises certifiées du réseau Yeeply sont en Espagne, où un ingénieur IA expérimenté coûte nettement moins cher qu’à Paris pour un niveau équivalent. Sur un projet de cette taille, cet écart fait souvent la différence entre un projet rentable et un projet repoussé.
Pour un chiffre plus proche de votre situation, notre calculatrice pose dix questions sur vos documents, leur stockage et les personnes qui doivent y accéder :
Les cas d’usage où le RAG est rentable
Les collaborateurs passent une bonne partie de leur semaine à chercher de l’information. Une étude de McKinsey souvent citée l’estimait à 1,8 heure par jour pour les employés de bureau dont le travail consiste surtout à manier de l’information. Voici les cas où un système RAG fait gagner ce temps le plus vite :
Savoir interne et intégration des nouveaux
Procédures RH, process, fiches produit et questions du type « comment on fait ici ? ». Les nouveaux arrivants arrêtent d’interrompre les trois mêmes personnes, qui retrouvent leurs après-midi.
Service client
Soit face aux clients, avec des réponses tirées de votre centre d’aide et un passage à un humain en cas de doute, soit pour l’équipe support, qui voit le bon passage du manuel à côté de chaque ticket. La seconde option est un point de départ plus sûr.
Juridique, conformité et contrats
Retrouver une clause, une date de renouvellement ou une obligation dans des centaines de contrats, de textes réglementaires ou de dossiers, avec un lien vers la page exacte. C’est là que les citations et les droits d’accès comptent le plus.
Propositions commerciales et appels d’offres
Rédiger les réponses aux appels d’offres à partir des propositions passées, des références et des fiches techniques. Le premier jet prend quelques minutes au lieu de plusieurs jours, et l’équipe se concentre sur ce qui est vraiment nouveau.
Techniciens terrain et documentation technique
Les techniciens interrogent depuis leur téléphone la documentation d’une machine ou d’une installation, y compris les fiches scannées et les plans.
Si l’assistant doit aussi agir, par exemple mettre à jour une fiche CRM ou réserver une intervention, on dépasse le RAG et on parle d’agent IA. Et pour un chatbot plus classique, nous détaillons les budgets dans notre article sur le prix d’un chatbot.
Comment démarrer un projet RAG
Les projets qui réussissent commencent petit et mesurable :
- Choisir une équipe et un type de question. « Le support répond aux questions produit » est un bon périmètre. « Tout le savoir de l’entreprise » n’en est pas un.
- Réunir 50 à 100 vraies questions que pose cette équipe, avec les bonnes réponses. Ce sera le test qui dira si le système fonctionne.
- Auditer les documents qui contiennent ces réponses : où ils sont, sous quel format, à quel point ils sont à jour, qui peut les voir.
- Construire le pilote et le mesurer sur ce jeu de questions avant que quiconque s’y fie.
- Étendre progressivement à d’autres sources et d’autres équipes une fois la précision au rendez-vous.
C’est exactement là que Yeeply intervient. Nous cadrons le périmètre avec vous, nous vous présentons des propositions d’entreprises certifiées de notre réseau qui ont déjà construit des systèmes similaires, et nous supervisons le projet jusqu’au lancement. Tout le détail est sur notre page RAG pour entreprise.
Pour recevoir une proposition adaptée à votre cas, cliquez sur « Recevoir un devis » en haut à droite de cette page ou écrivez à sales@yeeply.com. Dites-nous quels documents vous avez, où ils se trouvent et qui a besoin d’y trouver des réponses.
Tags
Publications similaires
Feuille de route pour se conformer à l’AI Act en 2026 : échéances et priorités
Guide pratique de conformité à l'AI Act 2026 : quelles échéances sont déjà passées, ce qu'apporte août 2026 et comment prioriser les actions selon votre type de système d'IA.
Qu’est-ce que l’AI Act européen et à qui s’applique-t-il ? Guide pratique 2026
Guide pratique de l'AI Act 2026 : pyramide des risques, qui doit se conformer, échéances déjà en vigueur et amendes jusqu'à 35 M€. Ce que les entreprises qui développent ou utilisent l'IA doivent savoir.
IA et gouvernance : pourquoi les DSI français ralentissent avant de mettre l’IA en production
Pourquoi les DSI français hésitent avant de mettre l’IA en production : risques réels, cadre réglementaire et bonnes pratiques de gouvernance IA pour 2026.
CSRD et systèmes d’information : les adaptations techniques que vos équipes IT doivent anticiper maintenant
Quelles adaptations techniques la CSRD impose à vos systèmes d’information : intégration des données, piste d’audit, Scope 3 et calendrier réaliste.
Logiciels ESG en France : ce que les entreprises françaises achètent (et ce qu’elles développent en interne)
Ce que les entreprises françaises achètent comme logiciels ESG en 2026, ce qu’elles développent en interne et comment choisir entre plateforme et sur-mesure.
MVP en 6 semaines : guide pas-à-pas pour les entreprises qui veulent tester avant d’investir
Un MVP en 6 semaines est réalisable si vous savez quoi y mettre. Ce guide couvre les phases, ce qu'il faut couper, les coûts réalistes et comment mesurer si ça a fonctionné.