


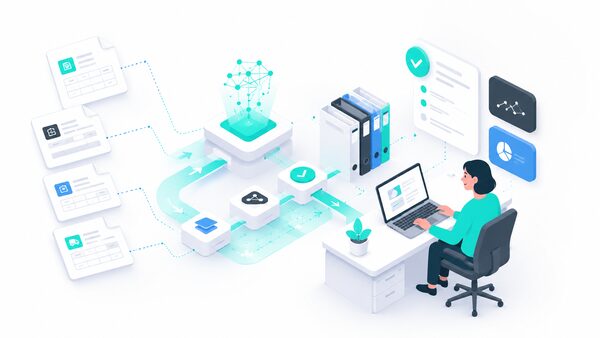
Fragen Sie ChatGPT nach Ihrer Urlaubsregelung, Ihrer Preisliste oder den Konditionen eines Vertrags, den Sie im Frühjahr unterschrieben haben. Entweder gibt es zu, dass es das nicht weiß, oder es liefert eine überzeugend klingende Antwort, die falsch ist. Ihre Dokumente hat es nie gesehen. RAG ist die Technik, die genau das löst, und sie steckt hinter den meisten „Frag unsere Dokumentation“-Assistenten, die Unternehmen in den letzten zwei Jahren eingeführt haben.
Was ist RAG also? Ein Verfahren, mit dem ein KI-Modell auf Ihre eigenen Informationen zugreift und aus Handbüchern, Richtlinien, Verträgen und Wissensartikeln antwortet statt aus dem Gedächtnis. Dieser Leitfaden erklärt verständlich, wie das funktioniert, woher die Informationen kommen, wie Berechtigungen und Datenschutz geregelt werden, was der Aufbau kostet und wo es sich lohnt. Wenn Sie schon wissen, dass Sie so etwas brauchen, springen Sie direkt zu den Kosten und berechnen Sie eine Schätzung für Ihren Fall.
Inhalt
- Was ist RAG?
- RAG und ChatGPT: Was ist der Unterschied?
- Woher bezieht ein RAG-System seine Informationen?
- Berechtigungen: Wer darf was sehen?
- Wie die Informationen aktuell bleiben
- Quellenangaben: wichtiger, als es aussieht
- Datenschutz und Sicherheit
- Was kostet ein RAG-System?
- Einsatzbereiche, in denen sich RAG lohnt
- So starten Sie ein RAG-Projekt
Was ist RAG?
RAG steht für Retrieval-Augmented Generation, also etwa „durch Suche ergänzte Textgenerierung“. Der Begriff stammt aus einem Forschungsartikel von Lewis und Kollegen bei Facebook AI Research aus dem Jahr 2020 und beschreibt die zwei Schritte, die das System bei jeder Frage ausführt:
- Suche (Retrieval). Das System durchsucht Ihre Dokumente und wählt die wenigen Textstellen aus, die am wahrscheinlichsten die Antwort enthalten.
- Generierung. Es schickt diese Stellen zusammen mit der Frage an ein Sprachmodell (GPT, Claude, Gemini, Llama o. Ä.) und gibt eine Anweisung mit: Antworte nur auf dieser Grundlage und sag es, wenn die Antwort nicht darin steht.
Die Antwort formuliert weiterhin das Modell, deshalb liest sie sich natürlich. Die Fakten kommen aber aus Ihren Dokumenten und nicht aus dem, was das Modell irgendwann im Training aufgenommen hat. Das ist die ganze Idee.
Damit die Suche funktioniert, werden die Dokumente vorab aufbereitet: Der Text wird extrahiert, in kurze Abschnitte zerlegt und in einem Index gespeichert, der nach Bedeutung statt nach exakten Wörtern durchsucht werden kann. So findet die Frage „Wie viele Urlaubstage habe ich nach dem ersten Jahr?“ auch den Absatz mit der Überschrift „Jahresurlaubsanspruch“. Im deutschsprachigen Raum spricht man bei solchen Lösungen oft einfach von einer KI-Wissensdatenbank.
RAG und ChatGPT: Was ist der Unterschied?
ChatGPT, Copilot oder Gemini sind für sich genommen allgemeine Assistenten. Sie schreiben, fassen zusammen und argumentieren sehr gut und wissen viel über die Welt bis zu ihrem Trainingsstand. Über Ihr Unternehmen wissen sie nichts, solange niemand die Informationen in das Gespräch kopiert.
Ein RAG-System übernimmt dieses Kopieren automatisch, bei jeder Frage, mit den richtigen Dokumenten und nur mit denen, die die fragende Person sehen darf.
| Allgemeiner Chatbot (ChatGPT pur) | RAG-System | |
|---|---|---|
| Woher die Antworten kommen | Aus dem Training des Modells | Aus Ihren Dokumenten, bei jeder Frage neu durchsucht |
| Unternehmenswissen | Nur, wenn man es hineinkopiert | Eingebaut, aus allen angebundenen Quellen |
| Wenn sich ein Dokument ändert | Bekommt es nicht mit | Nutzt ab der nächsten Indexierung die neue Fassung |
| Quellenangabe | Nein | Ja, Dokument und Seite |
| Wenn es etwas nicht weiß | Erfindet womöglich eine plausible Antwort | Kann angewiesen werden zu sagen: „Dazu finde ich nichts“ |
| Berechtigungen | Nicht vorhanden | Jeder bekommt nur Antworten aus dem, worauf er Zugriff hat |
Oft kommt die Frage, ob man „ChatGPT nicht einfach mit den eigenen Daten trainieren“ könne. Das heißt Fine-Tuning und ist für Unternehmenswissen meist das falsche Werkzeug: teuer, bei jeder Änderung zu wiederholen und ohne Quellenangabe. Fine-Tuning eignet sich, um einem Modell einen Stil oder ein Format beizubringen. Für Fakten ist RAG die richtige Wahl.
Woher bezieht ein RAG-System seine Informationen?
Von dort, wo Ihre Dokumente heute schon liegen. Ein gut gebautes System liest aus den vorhandenen Quellen, statt alle zu zwingen, ihre Dateien in ein neues Tool zu verschieben. Die üblichen Quellen sind:
- Ordner in SharePoint, OneDrive und Google Drive
- Wikis und Wissensdatenbanken wie Confluence oder Notion
- Dokumentenmanagementsysteme (DMS), in denen meist Verträge und Akten liegen
- Hilfeartikel und frühere Support-Tickets
- Strukturierte Daten aus CRM, ERP oder internen Datenbanken, wenn Antworten von aktuellen Zahlen abhängen
Welche Dokumente am besten funktionieren
Sauberer digitaler Text (Word-Dateien, Google Docs, am Rechner erzeugte PDFs) ist der einfache Fall. Schwieriger und teurer wird es mit eingescannten oder fotografierten Seiten, komplexen Tabellen und Excel-Dateien, technischen Zeichnungen und allem, was noch auf Papier liegt. All das muss erst in lesbaren Text umgewandelt werden, und genau dieser Teil wird im Budget am häufigsten unterschätzt.
Die zweite Falle ist die Qualität. Liegen auf dem Laufwerk drei Versionen derselben Richtlinie, findet das System alle drei. Zu jedem ernsthaften Projekt gehört deshalb die Entscheidung, welche Dokumente als gültig gelten und welche draußen bleiben.
Berechtigungen: Wer darf was sehen?
Das ist die Frage, die aus einem Zwei-Monats-Projekt ein Fünf-Monats-Projekt macht, und die im ersten Gespräch fast niemand stellt.
Darf jeder im Unternehmen jedes Dokument öffnen, sind Berechtigungen einfach. In den meisten Unternehmen ist das nicht so: Personalakten, Vorstandsprotokolle, Gehaltsbänder und Kundenverträge sind eingeschränkt. Ein RAG-System muss diese Einschränkungen in jeder Antwort beachten. Sonst könnte jeder den Assistenten nach Dingen fragen, die er selbst nicht öffnen darf, und die KI würde sie bereitwillig zusammenfassen.
Üblich sind drei Stufen:
- Für alle offen. Eine gemeinsame Wissensbasis ohne Einschränkungen. Die günstigste Variante und für öffentliche Hilfeinhalte völlig ausreichend.
- Pro Abteilung. Der Vertrieb sieht Vertriebsunterlagen, die Technik technische Dokumente. Mittlerer Aufwand.
- Pro Person oder pro Kunde. Das System prüft für jede Person die ursprünglichen Rechte jedes Dokuments, meist direkt aus SharePoint oder Google Drive. Die sicherste Variante und die aufwendigste.
Wie die Informationen aktuell bleiben
Ein großer Vorteil von RAG gegenüber einem nachtrainierten Modell: Aktualisierungen sind günstig. Ändert sich ein Dokument, muss nur dieses Dokument neu eingelesen werden. Wie oft das passiert, ist eine Designentscheidung:
- Ein nächtlicher oder wöchentlicher Abgleich reicht, wenn sich die Dokumente selten ändern.
- Aktualisierung nahezu in Echtzeit lohnt sich für Support-Inhalte, Preislisten und alles, was sich mehrmals pro Woche ändert.
- Gelöschte oder abgelaufene Dokumente müssen auch aus dem Index verschwinden. Das wird leicht vergessen und sorgt für einige der peinlichsten Falschantworten.
Quellenangaben: wichtiger, als es aussieht
Ein RAG-System weiß genau, welche Textstellen es für jede Antwort genutzt hat, und kann sie anzeigen. Manche Projekte nennen nur das Dokument, andere verlinken die genaue Seite und öffnen sie mit einem Klick.
Das klingt nach einem netten Extra. In der Praxis entscheidet es darüber, ob die Leute dem Tool vertrauen. Wer die Quelle in zwei Sekunden prüfen kann, verlässt sich auf die Antwort; wer das nicht kann, fragt wieder die Kollegin. Quellenangaben machen außerdem Fehler schnell sichtbar, und so wird das System besser.
Datenschutz und Sicherheit
Die erste Frage von IT und Rechtsabteilung lautet fast immer: Landen unsere Dokumente im Training einer fremden KI? Mit Geschäftsverträgen der großen Anbieter nicht. OpenAI erklärt zum Beispiel, dass es seine Modelle nicht mit Geschäftsdaten trainiert, die über die API oder die Enterprise-Produkte kommen, und Microsoft beschreibt, wie man RAG mit Azure AI Search in der eigenen Azure-Umgebung aufbaut.
Darüber hinaus zählen diese Entscheidungen:
- Wo die Daten verarbeitet werden. Für europäische Unternehmen sind Rechenzentren in der EU wegen der DSGVO in der Regel Pflicht.
- Welches Modell. Bei besonders sensiblen Informationen (Gesundheit, Finanzen, Recht) läuft das System mit Open-Source-Modellen in Ihrer eigenen Cloud, sodass nichts Ihre Infrastruktur verlässt.
- Protokollierung. Wer was gefragt hat und welche Dokumente genutzt wurden, sollte nachvollziehbar gespeichert werden.
- Transparenz. Nutzen Kunden oder die Öffentlichkeit den Assistenten, verlangt die europäische KI-Verordnung den Hinweis, dass sie mit einer KI sprechen.
Was kostet ein RAG-System?
Für ein Pilotprojekt weniger, als die meisten erwarten, für eine unternehmensweite Lösung mehr. Das KI-Modell ist selten der teure Teil. Den Preis bestimmen Zahl und Zustand der Dokumente, an wie vielen Orten sie liegen, das Berechtigungsmodell und ob Antworten seitengenaue Quellen nennen müssen.
| Projektart | Typischer Umfang | Umsetzung | Laufende Kosten |
|---|---|---|---|
| Pilotprojekt | Ein Team, eine Quelle, saubere Dokumente, einfache Weboberfläche | 5.000–15.000 € | 150–600 €/Monat |
| Abteilungslösung | Mehrere Quellen, Berechtigungen pro Abteilung, Quellenangaben, Teams oder Slack | 15.000–35.000 € | 600–2.000 €/Monat |
| Unternehmensweit | Viele Quellen, eingescannte Dokumente, Berechtigungen pro Person, sensible Daten | 35.000–60.000 €+ | ab 2.000 €/Monat |
Das sind unverbindliche Spannen für den europäischen Markt, zzgl. MwSt. Die laufenden Kosten decken KI-Modell, Suchindex und Hosting ab und steigen mit der Zahl der Anfragen. Ein Tool für 20 Mitarbeitende kostet im Betrieb also deutlich weniger als eines, das allen Kunden offensteht.
Auch der Standort des Teams macht einen Unterschied. Viele der zertifizierten Unternehmen in Yeeplys Netzwerk sitzen in Spanien, wo erfahrene KI-Entwickler deutlich weniger kosten als in München oder Frankfurt bei vergleichbarer Erfahrung. Bei einem Projekt dieser Größe entscheidet dieser Unterschied oft darüber, ob sich die Investition rechnet.
Für eine Zahl, die näher an Ihrem Fall liegt, stellt unser Rechner zehn Fragen zu Ihren Dokumenten, zur Ablage und dazu, wer Zugriff braucht:
Einsatzbereiche, in denen sich RAG lohnt
Mitarbeitende verbringen einen großen Teil ihrer Woche mit der Suche nach Informationen. Eine viel zitierte McKinsey-Studie kam auf 1,8 Stunden pro Tag bei Büroangestellten, deren Arbeit vor allem aus dem Umgang mit Informationen besteht. In diesen Fällen holt ein RAG-System diese Zeit am schnellsten zurück:
Internes Wissen und Einarbeitung
Richtlinien, Prozessbeschreibungen, Produktinformationen und „Wie machen wir das hier?“-Fragen. Neue Mitarbeitende unterbrechen nicht mehr ständig dieselben drei Kollegen, und die bekommen ihre Nachmittage zurück.
Kundenservice
Entweder direkt für Kunden, mit Antworten aus Ihrem Hilfecenter und Übergabe an einen Menschen bei Unklarheiten, oder für das Support-Team, das neben jedem Ticket die passende Stelle im Handbuch sieht. Die zweite Variante ist der sicherere Einstieg.
Recht, Compliance und Verträge
Eine Klausel, eine Kündigungsfrist oder eine Pflicht in Hunderten von Verträgen, Vorschriften oder Akten finden, mit Link auf die genaue Seite. Quellenangaben und Berechtigungen zählen hier am meisten.
Angebote und Ausschreibungen
Antworten auf Ausschreibungen aus früheren Angeboten, Referenzen und Datenblättern entwerfen. Der erste Entwurf dauert Minuten statt Tage, und das Team kümmert sich um das, was wirklich neu ist.
Servicetechnik und technische Dokumentation
Servicetechniker fragen per Smartphone nach einer Maschine oder Anlage und bekommen die Antwort aus dem Handbuch, auch aus eingescannten Blättern und Plänen.
Soll der Assistent auch handeln, etwa einen CRM-Eintrag aktualisieren oder einen Termin buchen, geht das über RAG hinaus und wird zum KI-Agenten. Und wenn Sie einen Chatbot brauchen, der live auf Daten aus CRM oder ERP zugreift statt auf Dokumente, erklären wir den Unterschied im Beitrag KI-Chatbot mit Datenanbindung erstellen.
So starten Sie ein RAG-Projekt
Projekte, die funktionieren, beginnen klein und messbar:
- Ein Team und eine Art von Frage wählen. „Support beantwortet Produktfragen“ ist ein guter Umfang, „das gesamte Unternehmenswissen“ nicht.
- 50 bis 100 echte Fragen sammeln, die dieses Team stellt, samt richtiger Antworten. Das wird der Test, der zeigt, ob das System funktioniert.
- Die Dokumente prüfen, die hinter diesen Antworten stehen: wo sie liegen, in welchem Format, wie aktuell, wer sie sehen darf.
- Den Pilot bauen und messen, bevor sich jemand darauf verlässt.
- Schrittweise erweitern auf weitere Quellen und Teams, sobald die Trefferquote stimmt.
Genau dabei unterstützt Yeeply. Wir klären mit Ihnen den Umfang, legen Ihnen Angebote zertifizierter Unternehmen aus unserem Netzwerk vor, die ähnliche Systeme gebaut haben, und begleiten die Umsetzung bis zum Start. Was dazugehört, sehen Sie auf unserer Seite zur KI-Wissensdatenbank für Unternehmen.
Wenn Sie ein Angebot für Ihren Fall möchten, klicken Sie oben rechts auf „Preisschätzung erhalten“ oder schreiben Sie an sales@yeeply.com. Erzählen Sie uns, welche Dokumente Sie haben, wo sie liegen und wer Antworten daraus braucht.
Stichwort
Ähnliche Posts
EU AI Act Roadmap für Unternehmen 2026: Fristen, Phasen und Prioritäten
Praxisguide zur AI-Act-Compliance 2026: welche Fristen bereits abgelaufen sind, was im August 2026 kommt und wie Unternehmen ihre Maßnahmen je nach KI-Systemtyp priorisieren.
Was ist der EU AI Act und wen betrifft er? Praxisleitfaden für Unternehmen 2026
Praxisleitfaden zum EU AI Act 2026: Risikopyramide, wer betroffen ist, bereits geltende Fristen und Bußgelder bis 35 Mio. €. Was Unternehmen, die KI entwickeln oder nutzen, jetzt wissen müssen.
CSRD und IT: Die technischen Pflichten, die deutsche Unternehmen jetzt angehen müssen
Welche IT-Anpassungen die CSRD von deutschen Unternehmen verlangt: Datenintegration, Scope 3, Pruefspur und realistischer Zeitplan fuer den Einstieg 2026.
Nachhaltige Softwareentwicklung: Was Green IT wirklich kostet und was es einspart
Was Green IT in der Softwareentwicklung kostet, was es einspart und wie es mit ESG- und CSRD-Anforderungen zusammenhaengt. Praxisnahe Massnahmen fuer 2026.
KI-Governance in der Praxis: Wie deutsche Unternehmen den Einsatz von KI im Code absichern
Wie deutsche Unternehmen KI-Systeme in Software absichern: was sie richtig machen, was sie falsch machen und der regulatorische Rahmen fuer 2026.
ESG-Reporting-Software: Was deutsche Unternehmen jetzt entwickeln müssen
Was deutsche Unternehmen fuer CSRD-konformes ESG-Reporting technisch benoetigen: Datenintegration, Berechnungs-Engine und wann kaufen oder selbst entwickeln.